
Mil pessoas, cem mil eleitores: de onde sai a margem de erro de uma pesquisa
Refaço à mão todas as contas por trás de uma pesquisa eleitoral: por que ouvir 1.000 de 100.000 pessoas funciona, de onde vem a margem de três pontos, e por que um intervalo de 95% acerta 94,98% das vezes — não 95%. Com a simulação em Julia que confirma cada número.
https://morrisonkuhlsen.com/margem-de-erro-pesquisa-eleitoral-amostragem/
Toda eleição a cena se repete: um instituto ouve mil pessoas, publica que um candidato tem 38% “com margem de erro de três pontos”, e alguém pergunta como mil pessoas podem dizer qualquer coisa sobre cem milhões.
A resposta curta é que podem — e o tamanho da população quase não entra na conta. A resposta longa são umas vinte fórmulas, e é o que este post faz: refaz à mão cada número que uma pesquisa reporta, num caso em que nós conhecemos a resposta verdadeira.
O truque para conhecê-la é inverter o problema. Em vez de partir de uma pesquisa e tentar adivinhar o eleitorado, eu invento o eleitorado inteiro e sorteio pesquisas dele. Aí dá para perguntar coisas que na vida real são inacessíveis: quantas pesquisas diferentes poderiam ter saído? Quantas delas errariam?
O eleitorado que eu inventei
São $N = 100.000$ eleitores, assim distribuídos:
| Categoria | Eleitores | Proporção |
|---|---|---|
| Vota em A | 38.600 | 38,6% |
| Vota em B | 37.200 | 37,2% |
| Branco/nulo | 3.600 | 3,6% |
| Abstenção | 20.600 | 20,6% |
O parâmetro de interesse é a proporção que vota em A:
\[P = \frac{K}{N} = \frac{38.600}{100.000} = 0{,}386.\]Uma escolha de modelagem que costuma passar batida: $P$ é a fração do eleitorado, não a dos votos válidos. Quem se abstém e quem anula entram no denominador. Entre os válidos seria $38.600/(38.600+37.200) = 50{,}92\%$ — um número bem diferente, respondendo a uma pergunta diferente. Vale reparar em qual das duas o instituto está reportando.
O passo que organiza tudo o que vem depois é codificar a população como zeros e uns: $a_i = 1$ se o eleitor $i$ vota em A, $0$ caso contrário. Então
\[P = \frac{1}{N}\sum_{i=1}^{N} a_i = \bar{a},\]e estimar uma proporção deixa de ser um problema especial — é estimar uma média. Toda a teoria de amostragem para médias passa a valer de graça.
Quantas pesquisas diferentes poderiam existir
A pesquisa ouve $n = 1.000$ pessoas por amostragem aleatória simples sem reposição: todos os subconjuntos de tamanho 1.000 têm a mesma chance de serem sorteados. Quantos são?
\[M = \binom{100.000}{1.000} \approx 1{,}7 \times 10^{2.430}.\]Esse número não cabe em nenhum tipo de ponto flutuante — o cálculo é feito em logaritmo, com $\ln\Gamma$. Para comparação, o universo observável tem cerca de $10^{80}$ átomos.
É essa coleção inimaginável que dá sentido a tudo o que vem depois. Quando se diz que um intervalo “tem 95% de confiança”, a frase é sobre essa população de $10^{2.430}$ pesquisas possíveis, não sobre a pesquisa que você tem na mão.
A distribuição exata
Quantos dos 1.000 entrevistados dizem A? Chame esse número de $y$. Sua distribuição é hipergeométrica:
\[P(y = k) = \frac{\binom{K}{k}\binom{N-K}{n-k}}{\binom{N}{n}}.\]A fórmula sai de contagem pura. Como todas as $\binom{N}{n}$ amostras são igualmente prováveis, $P(y = k)$ é a fração delas que tem exatamente $k$ eleitores de A. Para montar uma amostra assim, escolhem-se $k$ dos $K = 38.600$ eleitores de A, o que dá $\binom{K}{k}$ maneiras, e completa-se com $n - k$ dos $N - K = 61.400$ restantes, o que dá $\binom{N-K}{n-k}$. Cada escolha do primeiro grupo combina com qualquer uma do segundo, então as contagens se multiplicam. É a mesma conta de acertar $k$ números na Lotofácil, com eleitores no lugar das bolas.
O valor mais provável é $y = 386$, exatamente $nP$, e mesmo ele sai em só 2,60% das pesquisas. Se o sorteio fosse com reposição, $y$ seria binomial e essa probabilidade seria 2,59%: com a fração amostral de 1%, tirar alguém duas vezes é tão raro que as duas distribuições quase coincidem.
O estimador não é viesado
A pesquisa reporta $\hat{P} = y/n$. A primeira coisa a verificar é se ele erra sistematicamente para algum lado. Não erra:
\[E[\hat{P}] = P.\]A demonstração cabe em três linhas usando os indicadores de inclusão: cada eleitor tem probabilidade $\pi_i = n/N = 1\%$ de ser ouvido, e a soma dos indicadores devolve exatamente $P$.
Esse 1% é a fração amostral, e ela vai reaparecer.
De onde vem a margem de erro
A variância do estimador é
\[\operatorname{Var}(\hat{P}) = \frac{N-n}{N-1}\cdot\frac{Pq}{n},\]com $q = 1-P$. O primeiro fator é a correção de população finita, e é o responsável pela resposta à pergunta do começo do post. Aqui ela vale
\[\text{fpc} = \frac{99.000}{99.999} = 0{,}99001,\]ou seja, encolhe a variância em 1%. Praticamente nada. É por isso que o tamanho da população quase não importa: ouvir mil pessoas em um eleitorado de cem mil dá quase exatamente a mesma precisão que ouvir mil em um de cem milhões. O que manda é $n$, não $N$.
Fazendo a conta:
\[\operatorname{EP}(\hat{P}) = \sqrt{0{,}99001 \times \frac{0{,}237004}{1.000}} = 0{,}015318 = 1{,}53\%.\]O erro-padrão é o desvio-padrão da distribuição do estimador sobre as amostras possíveis. Não é o erro desta pesquisa — é a escala típica dos erros do procedimento.
A margem de erro é $t_{0{,}975}(999) \times \operatorname{EP}$, com $t_{0{,}975}(999) = 1{,}96234$:
\[1{,}96234 \times 0{,}015318 = 0{,}0301 = 3{,}01\text{ pontos}.\]Os três pontos do jornal.
Só que nenhum instituto publica exatamente esse número, porque ninguém conhece $P$. Cada pesquisa põe o seu próprio $\hat{P}$ no lugar de $P$ na fórmula do erro-padrão e, portanto, reporta uma margem um pouco diferente. A pesquisa da próxima seção, com $\hat{P} = 37{,}7\%$, reporta $\pm 2{,}99$; nos extremos do que é plausível aqui, de 35,7% a 41,6%, a margem vai de 2,96 a 3,04. Ela muda pouco porque $\hat{P}(1 - \hat{P})$ é quase plano perto de 50%.
O valor crítico $1{,}96234$ é o da distribuição t com 999 graus de liberdade (dá para conferir na tabela t); com tantos graus de liberdade, ele quase não difere do $1{,}96$ da normal. A calculadora de margem de erro do site usa o $1{,}96$ e chega a $\pm 3{,}00$, com a mesma cobertura exata de 94,98% que aparece mais abaixo.
Uma pesquisa concreta
A última pesquisa da simulação ouviu 1.000 eleitores e encontrou 377 dizendo A, ou seja $\hat{P} = 37{,}7\%$ contra os 38,6% verdadeiros. O intervalo dela:
\[\text{IC}_{95\%} = [34{,}71\%;\ 40{,}69\%].\]E $P = 38{,}6\%$ está dentro. Essa pesquisa acertou.
O que o intervalo não quer dizer: “há 95% de probabilidade de $P$ estar entre 34,71% e 40,69%”. $P = 0{,}386$ é um número fixo — ou está no intervalo, ou não está, e neste caso está, com probabilidade 1. Os 95% são do procedimento: das $10^{2.430}$ amostras possíveis, 95% produzem um intervalo que captura $P$.
Só que não são 95%.
A cobertura exata é 94,98%
Aqui está a parte que me fez querer escrever o post. Como a população é conhecida e finita, dá para calcular a cobertura exata — somar a probabilidade hipergeométrica de todos os $y$ cujo intervalo contém $P$. O resultado:
\[C = 94{,}9782\%.\]Não 95%. E o déficit não é erro de conta nem falta de amostras: é uma propriedade do procedimento. Duas causas, ambas verificáveis:
A discretude. $y$ só assume inteiros. A faixa contínua de cobertura ia de 356,41 a 416,45; a faixa discreta vai de 357 a 416. Perdeu-se um pedaço em cada ponta, e o arredondamento não tem motivo para compensar.
O erro-padrão estimado. A largura do intervalo é proporcional a $\sqrt{\hat{P}(1-\hat{P})}$, que cresce em direção a $\hat{P} = 0{,}5$. Como $P = 0{,}386 < 0{,}5$, as amostras que superestimam caminham na direção de 0,5, ganham intervalos mais largos e cobrem com mais facilidade; as que subestimam produzem intervalos mais estreitos e erram mais. Daí a cauda de baixo (2,66%) ser maior que a de cima (2,36%).
Duas consequências que vale dizer em voz alta: rodar mais pesquisas não conserta — a cobertura converge para 94,98%, não para 95%. E o efeito é maior quanto menor o $n$.
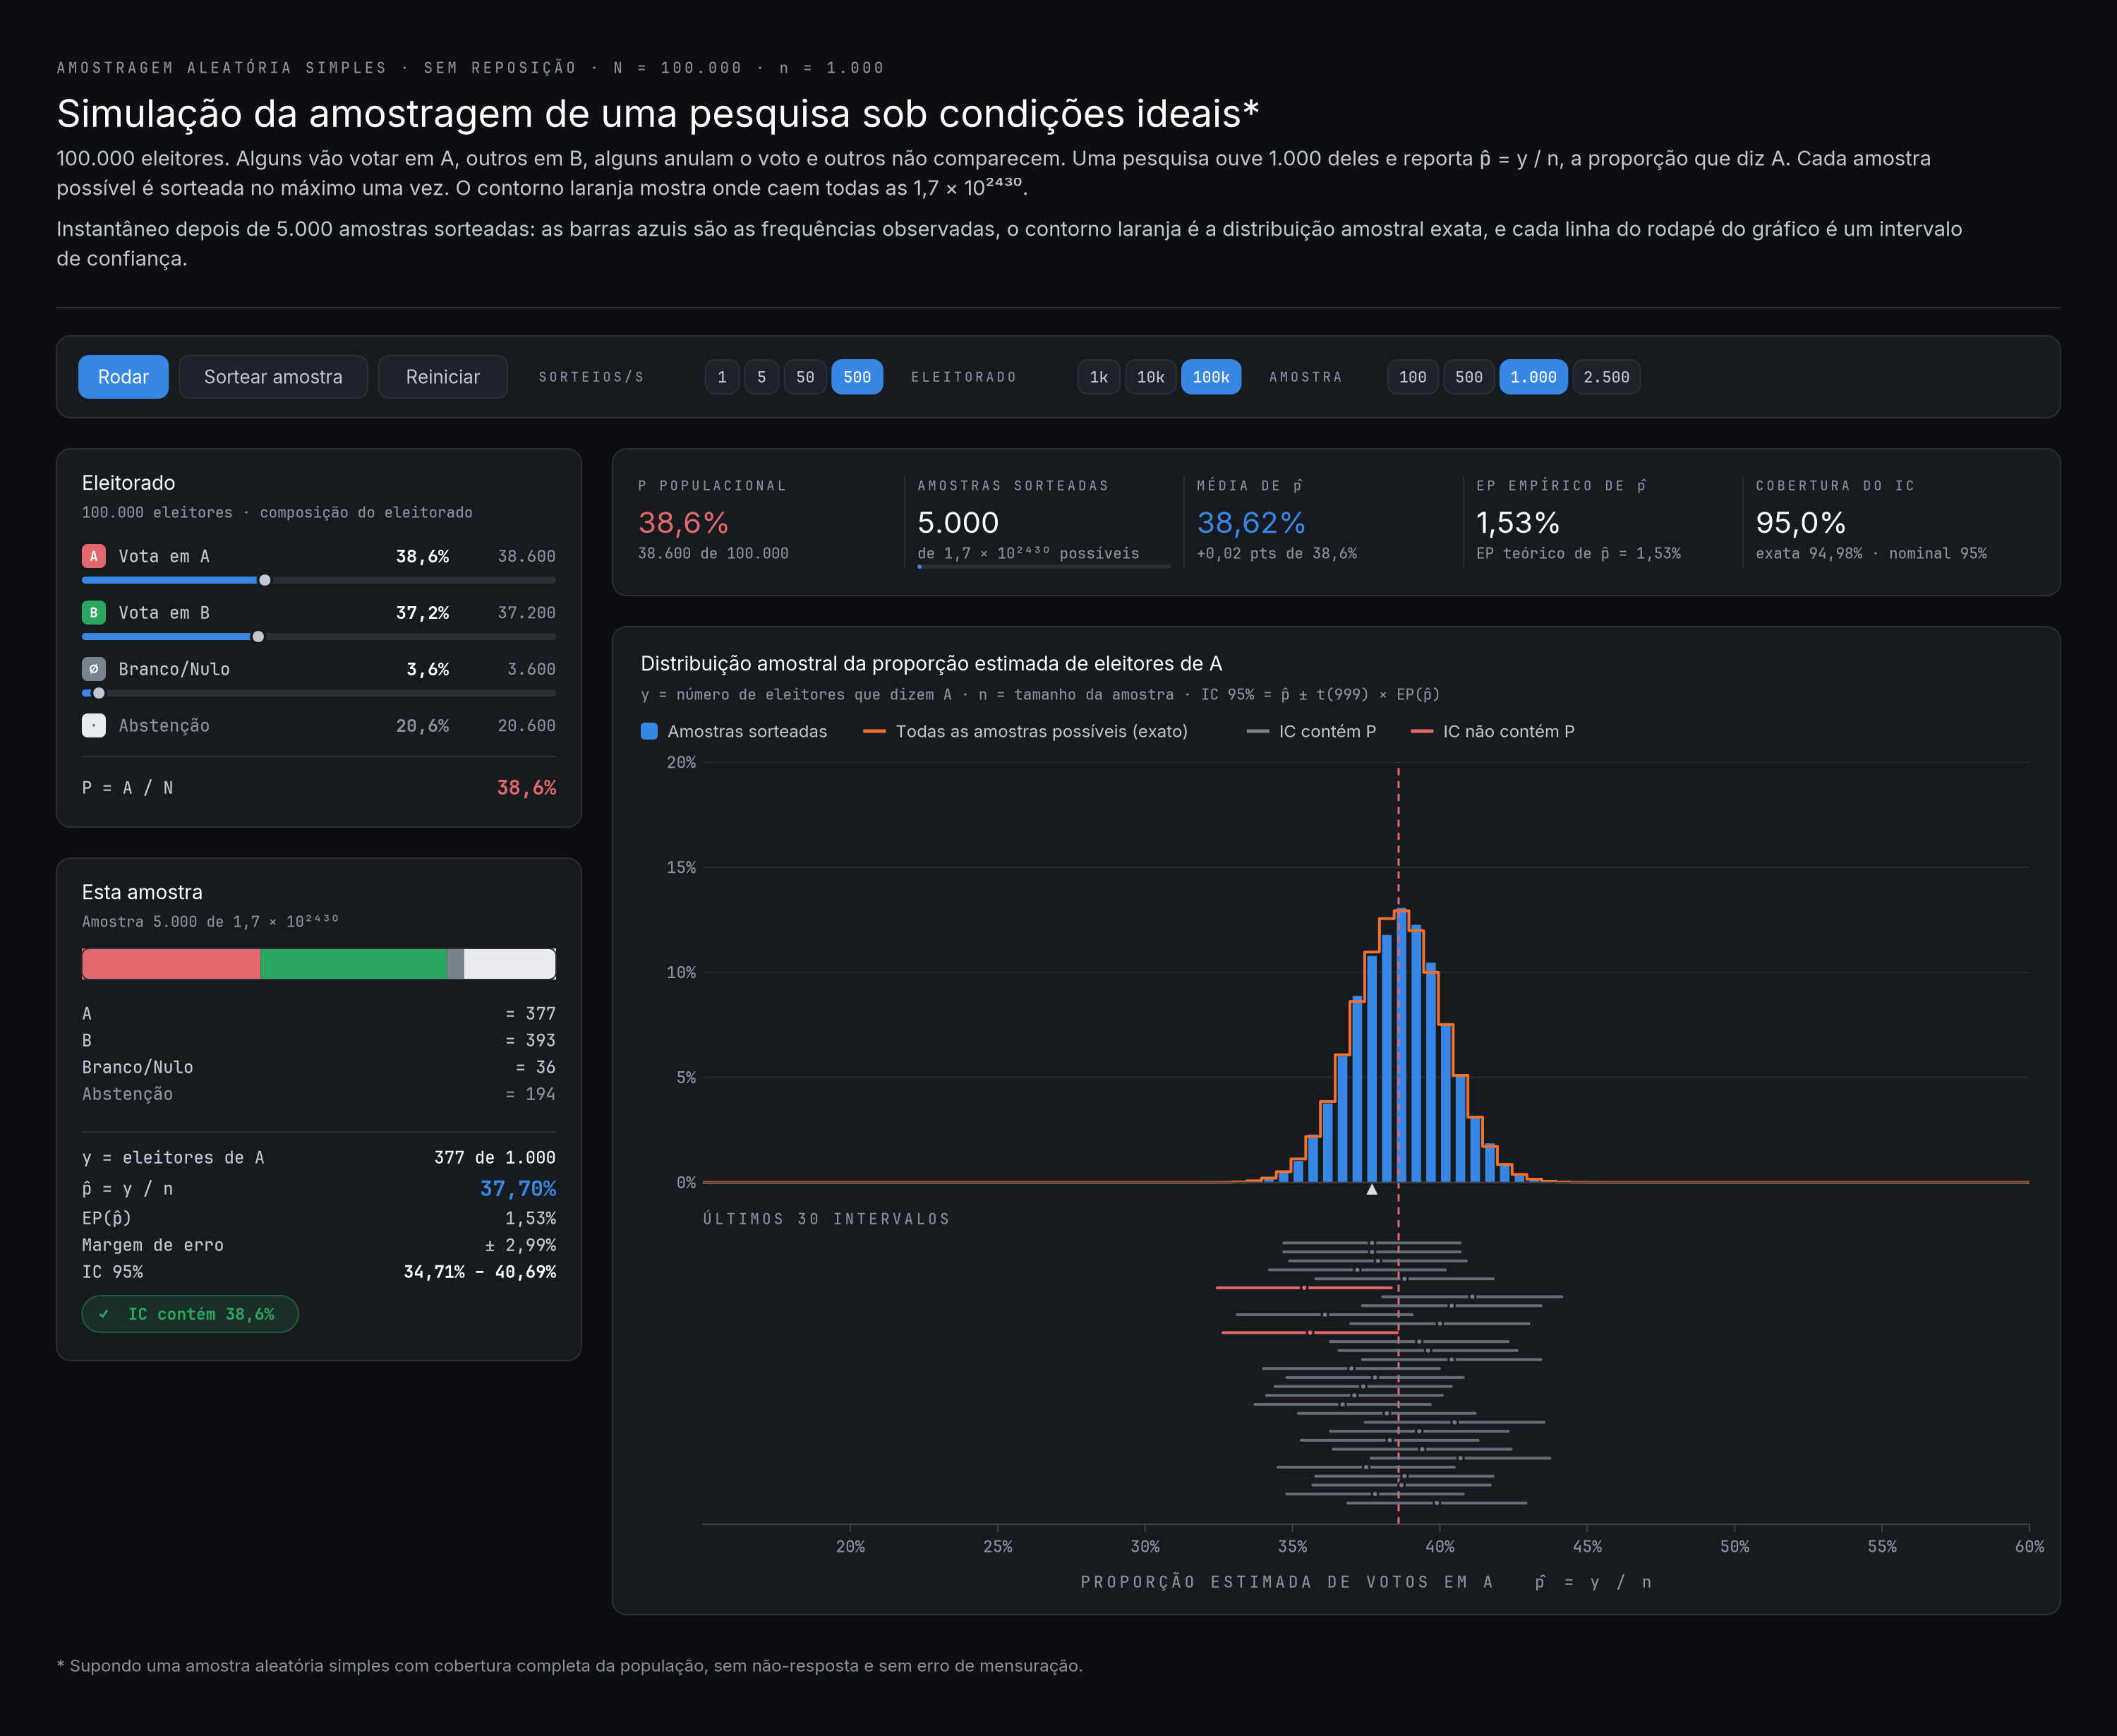
A simulação confirma
Sorteei 5.000 pesquisas desse eleitorado, em Julia:
| Quantidade | Observado | Teórico |
|---|---|---|
| Média de $\hat{P}$ | 38,6173% | 38,6000% |
| Erro-padrão de $\hat{P}$ | 1,5266% | 1,5318% |
| Cobertura do IC 95% | 94,98% | 94,9782% |
Os 4.749 intervalos que cobriram, contra 251 que erraram.
O viés observado de +0,017 ponto está a 0,8 erro-padrão de Monte Carlo de zero — compatível com o resultado teórico. E a cobertura observada persegue 94,98%, não 95%.
O núcleo do sorteio cabe em poucas linhas. Embaralhar o eleitorado inteiro e pegar os primeiros $n$ é uma amostra aleatória simples sem reposição:
using Distributions, Random, Statistics

N, n, K = 100_000, 1_000, 38_600
P = K / N
eleitorado = [fill(true, K); fill(false, N - K)]   # true = vota em A
fpc = (N - n) / (N - 1)
t = quantile(TDist(n - 1), 0.975)

function pesquisa(rng)
    amostra = shuffle(rng, eleitorado)[1:n]   # sem reposição
    p̂ = mean(amostra)
    margem = t * sqrt(fpc * p̂ * (1 - p̂) / n)
    (p̂, p̂ - margem <= P <= p̂ + margem)
end

rng = Xoshiro(2026)
res = [pesquisa(rng) for _ in 1:5_000]
println("média de p̂: ", mean(first.(res)))
println("cobertura:   ", mean(last.(res)))
Com essa semente, a cobertura sai 94,7%. Outra semente dá outro número: com 5.000 pesquisas, o erro de Monte Carlo da cobertura é de uns 0,3 ponto, e é por isso que só a conta exata separa 94,98% de 95%.
O mesmo experimento roda no navegador, no simulador de pesquisa: dá para sortear as pesquisas uma a uma, trocar o tamanho da amostra e ver a cobertura observada se aproximar da exata.
O que a margem de erro não mede
Tudo acima supõe amostragem aleatória simples com cobertura completa, sem não-resposta e sem erro de mensuração. Na prática:
- Desenhos complexos (conglomerados, estratos, pesos) mudam a variância por um fator — o efeito de desenho — que costuma ficar entre 1,5 e 3. Uma amostra de 1.000 por conglomerados pode ter a precisão de 400 por AAS.
- Não-resposta não aumenta a variância: introduz viés, que nenhum aumento de $n$ corrige. É o erro que não aparece na margem.
- Erro de mensuração — quem responde uma coisa e vota outra — também é viés, e também é invisível para a margem.
A margem de três pontos mede exclusivamente a variabilidade do sorteio. Ela é o menor erro possível, não o erro total. Quando duas pesquisas do mesmo dia divergem muito mais do que suas margens permitiriam, a explicação quase nunca está no sorteio.
Dá para resumir o post assim: o número que o jornal publica é o mais fácil de calcular e o menos importante dos erros. Os três pontos saem de uma fórmula de uma linha, valem para qualquer eleitorado grande e, como mostrou a conta exata, nem eles são exatamente o que prometem. O que decide se uma pesquisa acerta é quem ela conseguiu ouvir, e isso nenhuma margem de erro registra.
O código da simulação é um porte para Julia do painel de Raphael Nishimura.
Comentários