
A hipótese de Riemann, contada nos primos: zeros, ondas e uma escada refeita em Julia
O que a hipótese de Riemann diz, por que um problema sobre os zeros de uma função complexa é, no fundo, sobre os números primos, e o que dá para ver com um computador: os primeiros 20.000 zeros, a escada dos primos refeita com eles e um padrão estatístico que ninguém esperava — com código em Julia.
https://morrisonkuhlsen.com/hipotese-de-riemann-zeros-primos-julia/
A hipótese de Riemann tem uma fama esquisita. É o problema em aberto mais famoso da matemática, vale um milhão de dólares, e o enunciado dela parece não ter nada a ver com nada: todos os zeros não triviais da função zeta têm parte real igual a 1/2.
Eu passei anos sabendo recitar essa frase sem entender por que alguém se importaria com ela. Zeros de uma função complexa. Parte real 1/2. E daí?
O “e daí” é que essa frase é sobre os números primos. Mais precisamente, sobre quanto a distribuição dos primos pode se desviar de uma regra simples. Este post é a minha tentativa de chegar até aí com o mínimo de análise complexa e o máximo de conta feita no computador: calculei os primeiros 20.000 zeros, refiz a contagem dos primos a partir deles e acabei encontrando, num problema de teoria dos números, um histograma que parece ter saído de um livro de física.
Aviso logo: ninguém sabe se a hipótese é verdadeira. Nada aqui a prova. O que dá para fazer é ver o que ela diz, e o que estaria em jogo se fosse falsa.
A ideia, antes de qualquer fórmula
Imagine uma estrada infinita com uma placa em cada número inteiro, e você andando por ela com um caderno, anotando os primos que encontra pelo caminho.
No começo eles aparecem a toda hora: 2, 3, 5, 7, 11, 13. Depois vão rareando, num ritmo que dá para prever. Perto da placa mil, a distância média entre um primo e o seguinte é de umas 7 placas; perto de um milhão, de 14; perto de um bilhão, de 21. (A regra é que, perto de $x$, essa distância média é $\ln x$.) Essa parte está resolvida desde 1896: no longo prazo, a média nunca falha.
Mas quem anda pela estrada não vê a média. Vê o caminho de perto, e de perto os primos não têm ritmo nenhum:
- Logo depois de um bilhão vem um par colado: 1.000.000.007 e 1.000.000.009. O par seguinte só aparece 402 placas depois.
- Antes de mil, o trecho mais longo sem primos vai de 887 a 907: são 19 placas vazias seguidas, quase o triplo da distância média por ali.
- Antes de um milhão, o recorde é de 492.113 a 492.227: 113 placas sem nenhum primo, onde a média seria 13.
- Logo depois de um bilhão, entre 1.002.901.069 e 1.002.901.279, são 209 placas vazias, dez vezes a média local.
- Divida os 10 milhões de placas depois de um bilhão em trechos de mil. Em média, cada trecho tem 48 primos. Mas houve trecho com 29 e trecho com 71.
Nada disso é aleatório: se um número é primo ou não está decidido desde sempre. Mesmo assim, ninguém consegue dizer onde vai cair o próximo primo sem ir lá conferir. E aí vem a pergunta que interessa: até onde a realidade pode se afastar da média?
Dá para imaginar estradas bem piores que a nossa. Uma em que, lá pela placa $10^{100}$, os primos simplesmente somem por um trecho gigantesco e depois reaparecem em bando, compensando o atraso. A média de longo prazo continuaria certa, mas quem estivesse no meio do caminho contaria muito menos primos do que a regra promete, e por muito tempo.
A hipótese de Riemann diz que a nossa estrada não é assim. Depois de andar até a placa $x$, o seu caderno nunca vai discordar da conta da média por mais do que algo da ordem de $\sqrt{x}$ (vezes um logaritmo). Parece muito, mas é quase nada. Até um bilhão você anota 50.847.534 primos, a média previa 50.849.235, e a hipótese só permitiria uma diferença de uns 26 mil, cerca de 0,05% do total. A diferença real é 1.701.
E não é só no total. Se a hipótese for verdadeira, nenhum deserto pode ser comprido demais: depois da placa $x$, o próximo primo aparece no máximo a uma distância da ordem de $\sqrt{x}\,\ln x$ (Harald Cramér provou isso em 1920, supondo a hipótese). Os desertos existem e crescem sem limite, mas crescem devagar perto do tamanho da estrada. O de 209 placas, logo depois de um bilhão, está a anos-luz do que esse limite permitiria, que é da ordem de 600 mil.
Por que justamente $\sqrt{x}$? Uma intuição é pensar em moedas. Jogue um bilhão de moedas: a quantidade de caras vai ficar perto de meio bilhão, mas quase nunca exatamente; o desvio típico é de uns 16 mil, que é $\sqrt{x}/2$. A hipótese diz que os primos, que não têm nada de sorteados, oscilam em torno da média no máximo tanto quanto oscilaria uma coisa sorteada ao acaso. Parecem espalhados sem regra, mas o tamanho das oscilações tem dono.
E quem é o dono, mais adiante, fica literal: as oscilações dos primos são uma soma de ondas, uma para cada zero da função zeta, e a parte real do zero dita quanto a onda dele cresce. Parte real 1/2 quer dizer que toda onda cresce como $\sqrt{x}$. Um único zero fora da reta seria uma onda crescendo mais rápido que as outras, e aí sim, em algum lugar muito longe na estrada, os primos sairiam do controle.
Também por isso conferir no computador não basta. Os primeiros 12 trilhões de zeros já foram verificados, todos na reta. Mas são infinitos, e o zero que estragaria tudo pode estar numa altura que nenhum computador vai alcançar. É o mesmo problema da estrada: dá para andar um trecho enorme, mas nunca até o fim.
Primeiro, os primos
Os números primos não seguem padrão aparente: 2, 3, 5, 7, 11, 13, 17, 19, 23… Às vezes vêm colados (11 e 13), às vezes somem por um tempo (não há nenhum entre 114 e 126). Mas, olhados de longe, eles ficam surpreendentemente comportados.
Seja $\pi(x)$ a quantidade de primos até $x$ — o $\pi$ aqui não tem nada a ver com 3,14; é só a notação que pegou. Gauss, ainda adolescente, olhou tabelas de primos e chutou que, perto de um número $x$, a chance de um inteiro ser primo é mais ou menos $1/\ln x$. Somando essa “densidade” até $x$, sai a integral logarítmica:
\[\operatorname{li}(x) = \int_0^x \frac{dt}{\ln t}.\](A integral passa por cima de $t = 1$, onde $\ln t = 0$, e é tomada no sentido de valor principal. Muitos textos começam em 2 e escrevem $\operatorname{Li}(x)$; a diferença entre as duas é uma constante, $\operatorname{li}(2) = 1{,}045$, que não muda nada aqui. Uso a que começa em 0 porque é com ela que as cotas mais adiante são enunciadas.)
Contei os primos até um bilhão com um crivo de Eratóstenes em Julia (leva uns dez segundos) e comparei:
| $x$ | $\pi(x)$ | $x / \ln x$ | $\operatorname{li}(x)$ | $\pi(x) - \operatorname{li}(x)$ |
|---|---|---|---|---|
| $10^3$ | 168 | 145 | 177,6 | −9,6 |
| $10^4$ | 1.229 | 1.086 | 1.246,1 | −17,1 |
| $10^5$ | 9.592 | 8.686 | 9.629,8 | −37,8 |
| $10^6$ | 78.498 | 72.382 | 78.627,5 | −129,5 |
| $10^7$ | 664.579 | 620.421 | 664.918,4 | −339,4 |
| $10^8$ | 5.761.455 | 5.428.681 | 5.762.209,4 | −754,4 |
| $10^9$ | 50.847.534 | 48.254.942 | 50.849.235,0 | −1.701,0 |
Até um bilhão, $\operatorname{li}(x)$ erra por 1.701 primos, num total de 50 milhões: um erro de 0,003%. A versão mais simples, $x/\ln x$, erra por 5%.
Que $\pi(x)/\operatorname{li}(x)$ tende a 1 é o teorema dos números primos, demonstrado em 1896, de forma independente, por Hadamard e por de la Vallée Poussin. A hipótese de Riemann é sobre a coluna da direita: o tamanho do erro.
A ponte de Euler
A ligação entre primos e a função zeta é de Euler, de 1737, e é a coisa mais bonita deste post. Para $s > 1$, defina
\[\zeta(s) = \sum_{n=1}^{\infty} \frac{1}{n^s} = 1 + \frac{1}{2^s} + \frac{1}{3^s} + \frac{1}{4^s} + \cdots\]Euler percebeu que essa soma sobre todos os inteiros é igual a um produto sobre os primos:
\[\zeta(s) = \prod_{p \text{ primo}} \frac{1}{1 - p^{-s}} = \frac{1}{1 - 2^{-s}} \cdot \frac{1}{1 - 3^{-s}} \cdot \frac{1}{1 - 5^{-s}} \cdots\]O motivo é a fatoração única. Cada fator é uma série geométrica, $1 + p^{-s} + p^{-2s} + \cdots$. Multiplicando todas, cada combinação de potências de primos aparece exatamente uma vez — e cada combinação de potências de primos é exatamente um inteiro. O produto “sabe” quais números são primos; a soma não parece saber, mas é a mesma coisa.
Isso quer dizer que tudo o que se descobrir sobre $\zeta$ é, de algum jeito, informação sobre os primos.
O que Riemann fez em dez páginas
Em 1859, Bernhard Riemann publicou o único artigo da vida dele sobre teoria dos números, Sobre a quantidade de primos menores que uma grandeza dada. Tem dez páginas. Fez duas coisas.
A primeira foi estender $\zeta(s)$ para $s$ complexo. A soma só converge quando a parte real de $s$ passa de 1, mas existe uma única maneira “suave” (analítica) de definir a função no plano inteiro, exceto em $s = 1$. Essa extensão tem zeros:
- os triviais, em $-2, -4, -6, \ldots$, que são fáceis e não interessam aqui;
- e os não triviais, que caem todos na faixa $0 < \operatorname{Re}(s) < 1$ — a faixa crítica. Eles vêm em pares simétricos em relação à reta $\operatorname{Re}(s) = 1/2$, a reta crítica, e em relação ao eixo real.
A segunda foi uma fórmula exata para contar primos a partir desses zeros. Chego nela já já.
E, no meio do artigo, quase de passagem, Riemann escreveu que é “muito provável” que todos os zeros não triviais estejam sobre a reta crítica. E completou: “Seria desejável, claro, uma demonstração rigorosa disso; deixei de lado a busca por ela, por ora, depois de algumas tentativas rápidas e inúteis”.1
Isso foi há 167 anos. As tentativas continuam inúteis.
Vendo os zeros
Em $s = \tfrac12 + it$, a função $\zeta$ devolve um número complexo. Quando $t$ anda de 0 a 34, esse número descreve uma curva no plano — e a curva passa pela origem exatamente nos zeros. Calculei com o Arblib, que usa aritmética de intervalos e devolve cada valor com uma margem de erro garantida:
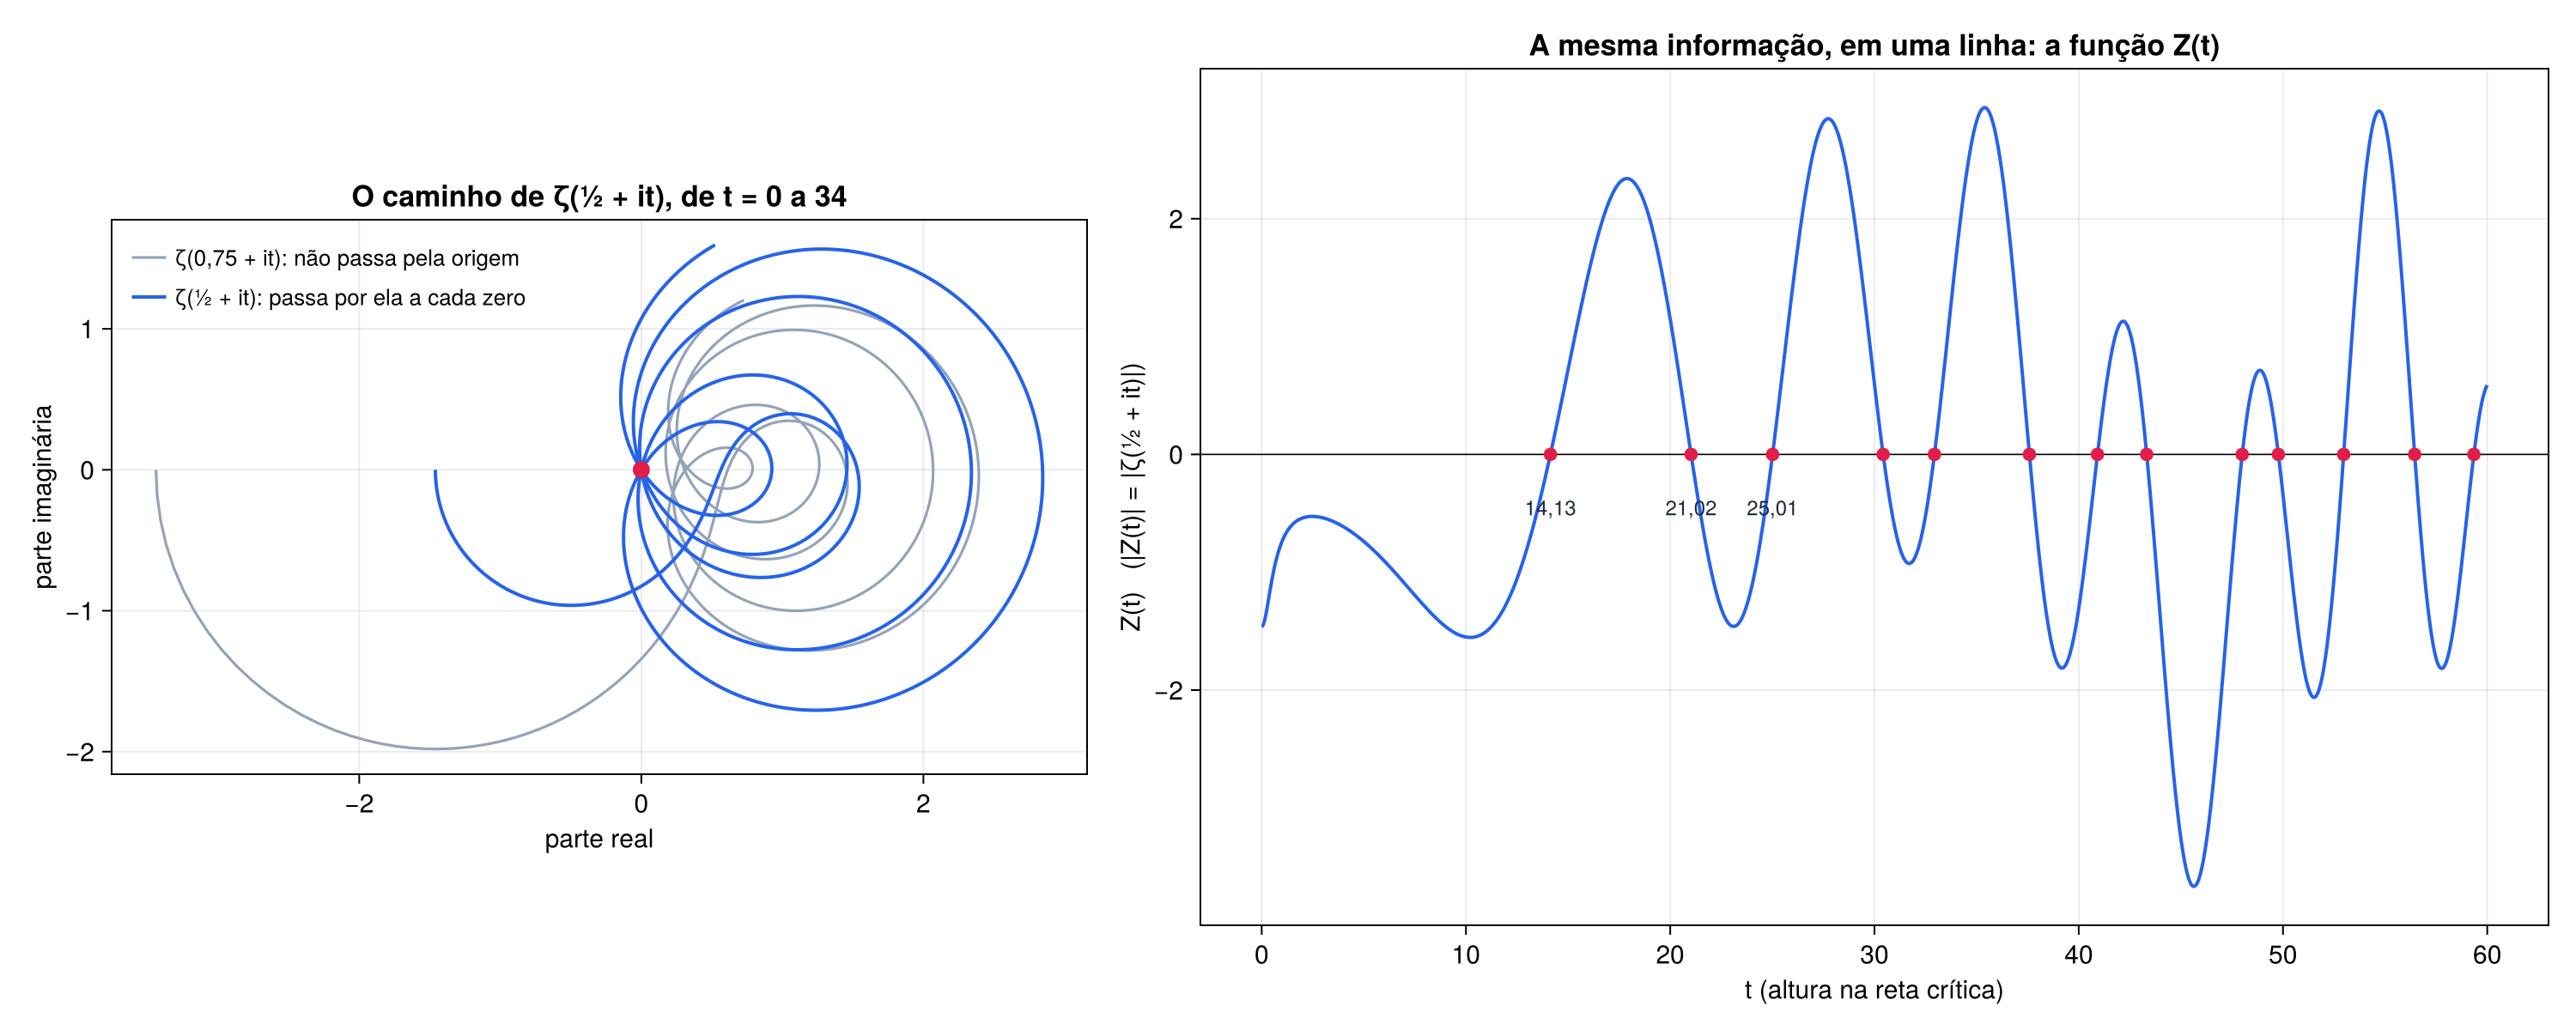
O primeiro zero está em $t = 14{,}1347\ldots$; depois vêm 21,0220, 25,0109, 30,4249… Até $t = 60$ são 13. Eles ficam cada vez mais juntos: a quantidade de zeros até a altura $T$ cresce como $\tfrac{T}{2\pi}\ln\tfrac{T}{2\pi e}$, então perto de $T$ a distância média entre dois vizinhos é $2\pi / \ln(T/2\pi)$. O 20.000º zero, o último que calculei, está em $t = 18.046{,}46$.
O painel da direita é o truque que se usa na prática. Existe uma função real, $Z(t)$, com $\lvert Z(t)\rvert = \lvert \zeta(\tfrac12 + it)\rvert$. Achar zeros na reta crítica vira achar trocas de sinal de uma função real — coisa que dá para certificar com aritmética de intervalos. A fórmula para calcular $Z(t)$ rápido é a de Riemann–Siegel, e tem uma história boa: Carl Siegel a encontrou em 1932 nas anotações não publicadas de Riemann, que já tinha calculado os primeiros zeros à mão e nunca publicou o método.
Uma ressalva de método sobre os meus 20.000 zeros: eu não verifiquei que eles estão na reta. O Arblib procura os zeros justamente na reta crítica, como trocas de sinal de $Z(t)$, então a parte real 1/2 que ele devolve é construção, não medida. O que garante que nenhum zero escapou para fora da reta até essa altura é outra conta: comparar quantas trocas de sinal se encontrou com quantos zeros existem no total abaixo daquela altura, que dá para calcular sem saber onde eles estão (é o método de Alan Turing, de 1953). Para os primeiros 20.000 isso foi feito há muito tempo, e muito além deles, como conto no fim. E, de todo modo, nada disso prova a hipótese.
A escada refeita com ondas
Agora a parte que transformou a hipótese, para mim, de curiosidade em coisa que faz sentido.
Em vez de $\pi(x)$, é mais limpo trabalhar com a função de Chebyshev, $\psi(x)$: uma escada que sobe $\ln p$ em cada primo $p$ e em cada potência dele ($p^2, p^3, \ldots$). Ela carrega a mesma informação que $\pi(x)$ e o teorema dos números primos vira simplesmente $\psi(x) \approx x$.
A fórmula explícita, que von Mangoldt demonstrou em 1895 seguindo o caminho de Riemann, diz que a escada é exatamente igual a
\[\psi(x) = x \;-\; \sum_{\rho} \frac{x^{\rho}}{\rho} \;-\; \ln(2\pi) \;-\; \tfrac12 \ln\!\left(1 - x^{-2}\right),\]onde a soma percorre todos os zeros não triviais $\rho$, em pares conjugados e em ordem crescente de altura, e $x$ não é uma potência de primo (em cima de um degrau, a fórmula dá o ponto médio do salto). O termo $x$ é a tendência suave. Cada zero acrescenta uma correção. Escrevendo $\rho = \beta + i\gamma$, um zero e o seu conjugado juntos contribuem
\[\frac{x^{\rho}}{\rho} + \frac{x^{\bar\rho}}{\bar\rho} = \frac{2\, x^{\beta}}{|\rho|} \cos\!\left(\gamma \ln x - \arg \rho\right),\]uma onda em $\ln x$ com frequência $\gamma$ e amplitude $x^{\beta}/\lvert \rho\rvert$. Os zeros são as frequências da música dos primos — a metáfora é velha, mas aqui ela é literal.
Fiz a conta com os 10 e com os 1.000 primeiros zeros:
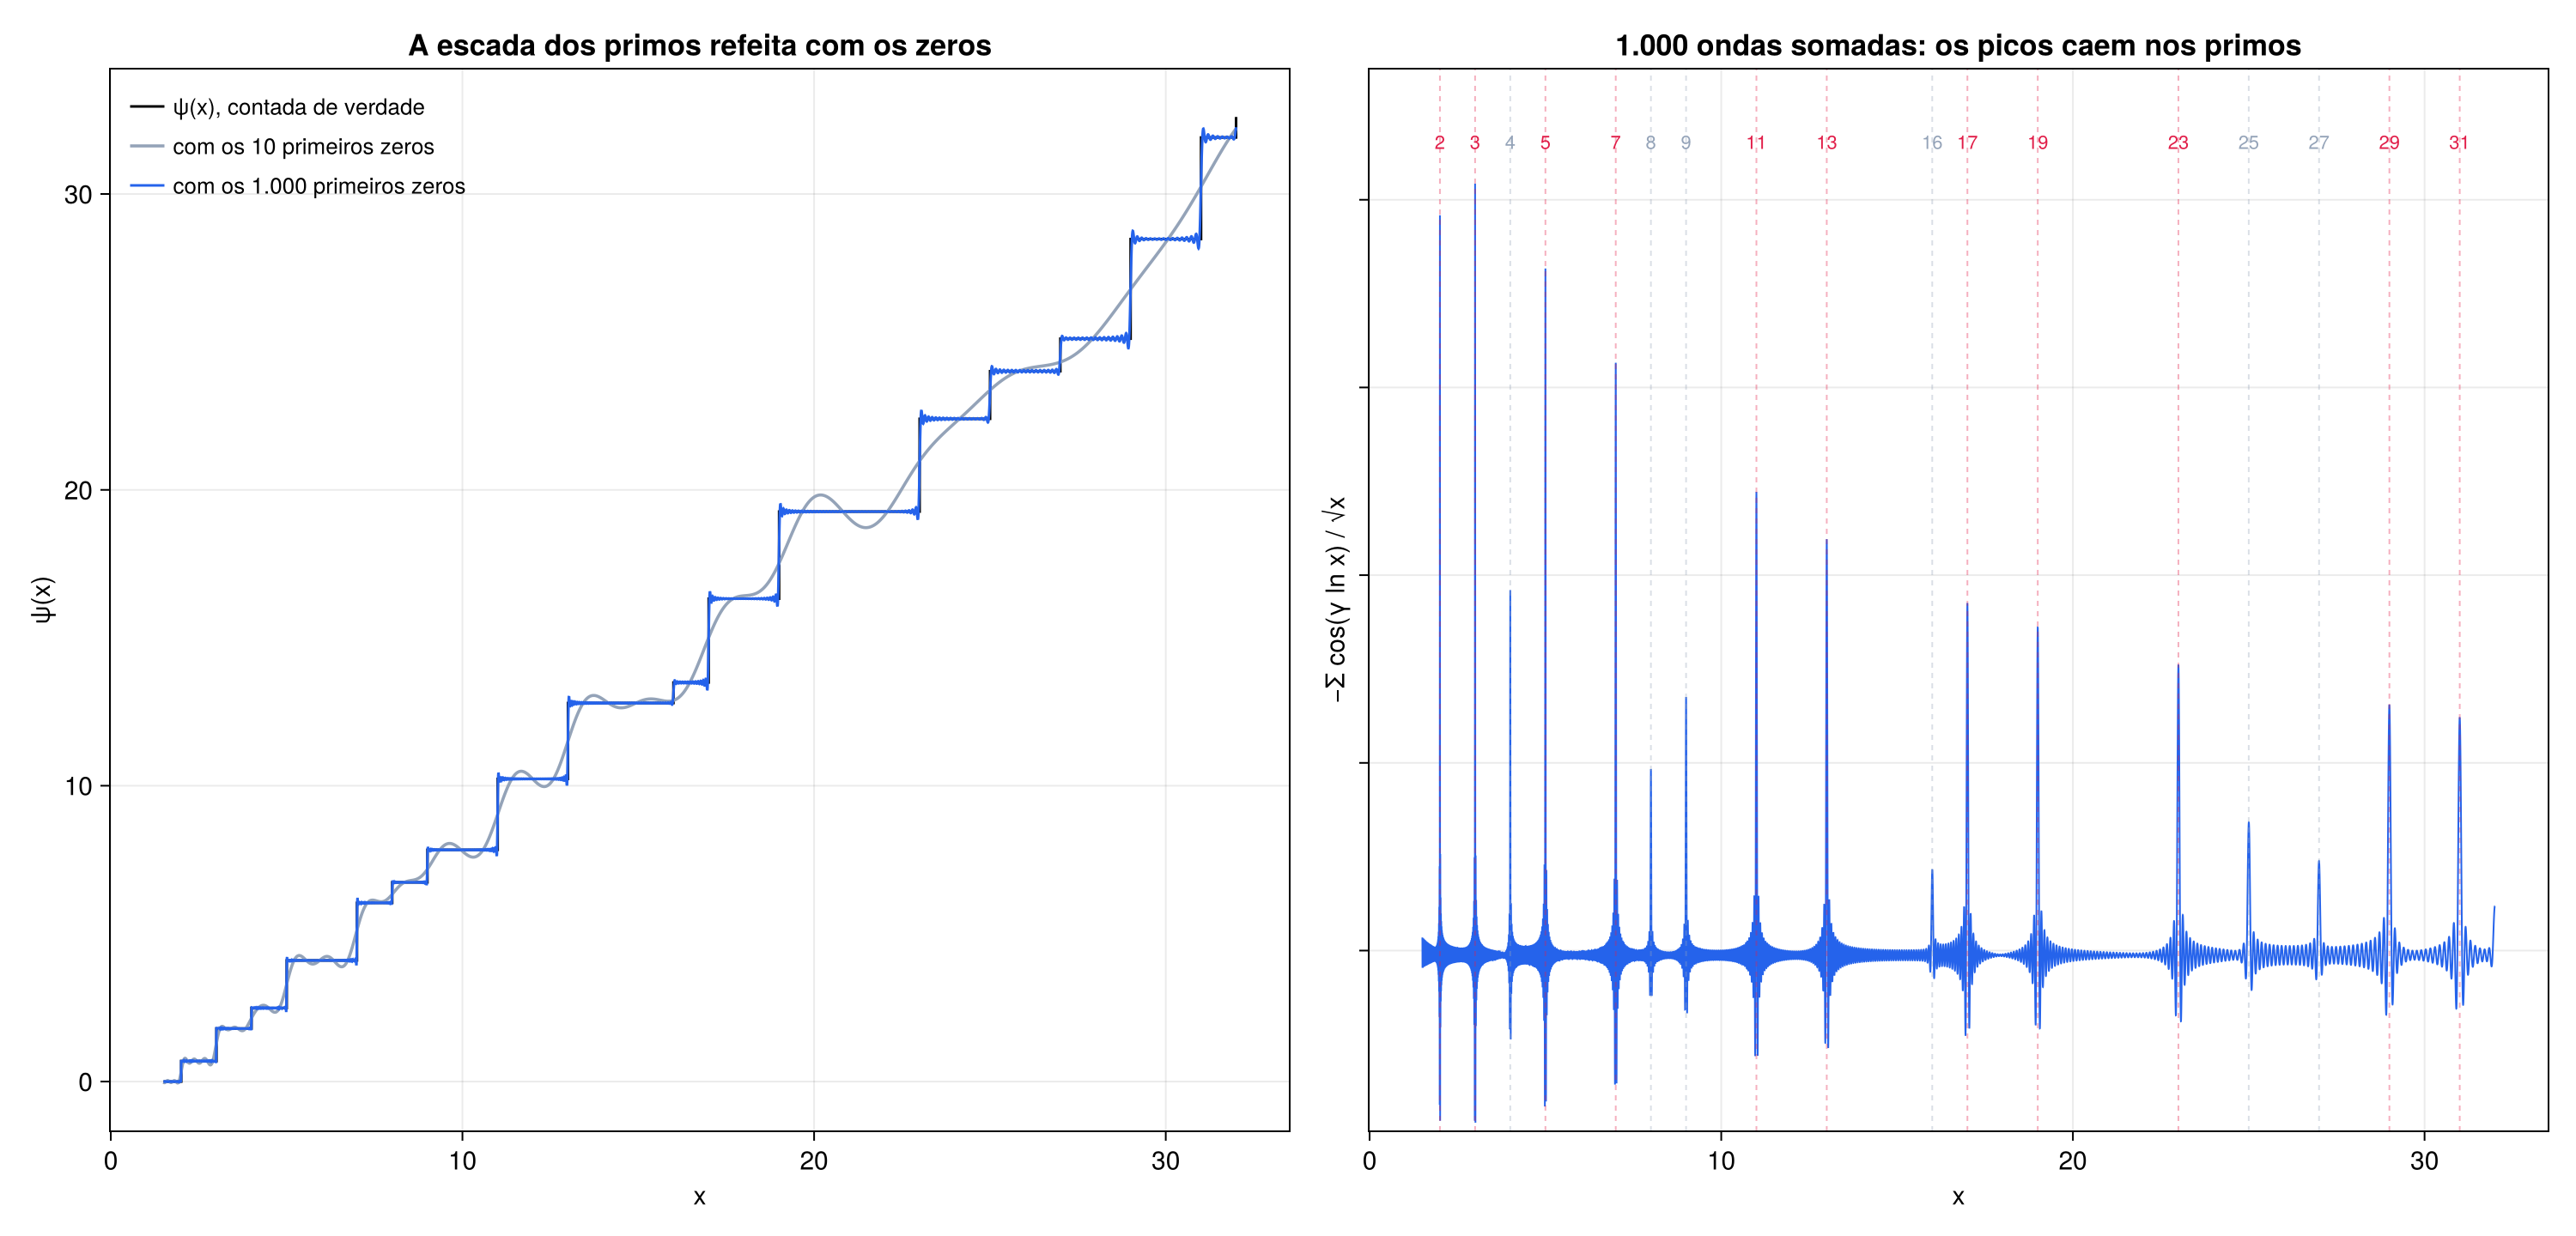
Com dez zeros, a curva cinza já sabe mais ou menos onde ficam os degraus. Com mil, a azul fica em cima da escada. E o painel da direita me impressionou mais que qualquer explicação: some mil cossenos cujas frequências são as partes imaginárias dos zeros, e os picos aparecem em 2, 3, 5, 7, 11, 13… Ninguém disse à soma quais números são primos. Os picos das potências são menores que os dos primos vizinhos porque o degrau em $p^k$ é $\ln p$, e não $\ln p^k$: em 8 a escada sobe $\ln 2$, como em 2.
O código que reconstrói $\psi(x)$:
using Arblib

# parte imaginária dos primeiros N zeros não triviais
N = 1000
γ = [imag(Arblib.fpwrap_zeta_zero(UInt(n))) for n in 1:N]

# a fórmula explícita: ψ(x) a partir dos zeros
function ψ_zeros(x, γ)
    ondas = sum(2real(x^(0.5 + im*g) / (0.5 + im*g)) for g in γ)
    x - ondas - log(2π) - log(1 - x^-2) / 2
end

# ψ(x) contada diretamente: ln p para cada potência de primo pᵏ ≤ x
ehprimo(n) = n ≥ 2 && all(n % d != 0 for d in 2:isqrt(n))
function ψ_direto(x)
    total = 0.0
    for p in 2:floor(Int, x)
        ehprimo(p) || continue
        q = p
        while q ≤ x; total += log(p); q *= p; end
    end
    total
end

ψ_direto(30.5), ψ_zeros(30.5, γ[1:10]), ψ_zeros(30.5, γ)
# (28.476, 29.248, 28.463)
O 0.5 dentro de ψ_zeros é a hipótese de Riemann usada como atalho: eu
escrevi a parte real de todo zero como 1/2. Para esses mil, isso é sabido
que vale (pela verificação que mencionei acima). Mas é bom saber que a
hipótese está ali, escondida num literal.2
Por que 1/2 importa
Agora dá para responder o “e daí” do começo.
A amplitude da onda de cada zero é $x^{\beta}/\lvert \rho\rvert$, e $\beta$ é a parte real do zero. Se todos os zeros têm $\beta = 1/2$, toda onda cresce como $\sqrt{x}$. O erro de aproximar os primos pela curva suave fica, então, do tamanho de $\sqrt{x}$ — um pouco mais, por causa do logaritmo e da quantidade de ondas.
Se houvesse um único zero com $\beta = 0{,}8$, a onda dele cresceria como $x^{0{,}8}$ e, para $x$ grande o bastante, engoliria todas as outras. Os primos se afastariam da curva suave muito mais do que se vê. E não dá para ter um zero só com $\beta < 1/2$ para “compensar”: pela simetria, um zero em $\beta$ vem acompanhado de um em $1 - \beta$, e um dos dois está à direita da reta.
Isso foi tornado preciso por Helge von Koch em 1901: a hipótese de Riemann é equivalente a
\[\pi(x) = \operatorname{li}(x) + O\!\left(\sqrt{x}\,\ln x\right).\]Equivalente, nos dois sentidos. Em 1976, Lowell Schoenfeld deu até a constante: se a hipótese for verdadeira, então para todo $x \geq 2.657$,
\[\left|\pi(x) - \operatorname{li}(x)\right| < \frac{\sqrt{x}\,\ln x}{8\pi}.\]Então a hipótese de Riemann é, no fundo, a afirmação de que os primos são tão bem distribuídos quanto poderiam ser. O “1/2” é o expoente do erro.
Comparei a contagem real com essa cota:
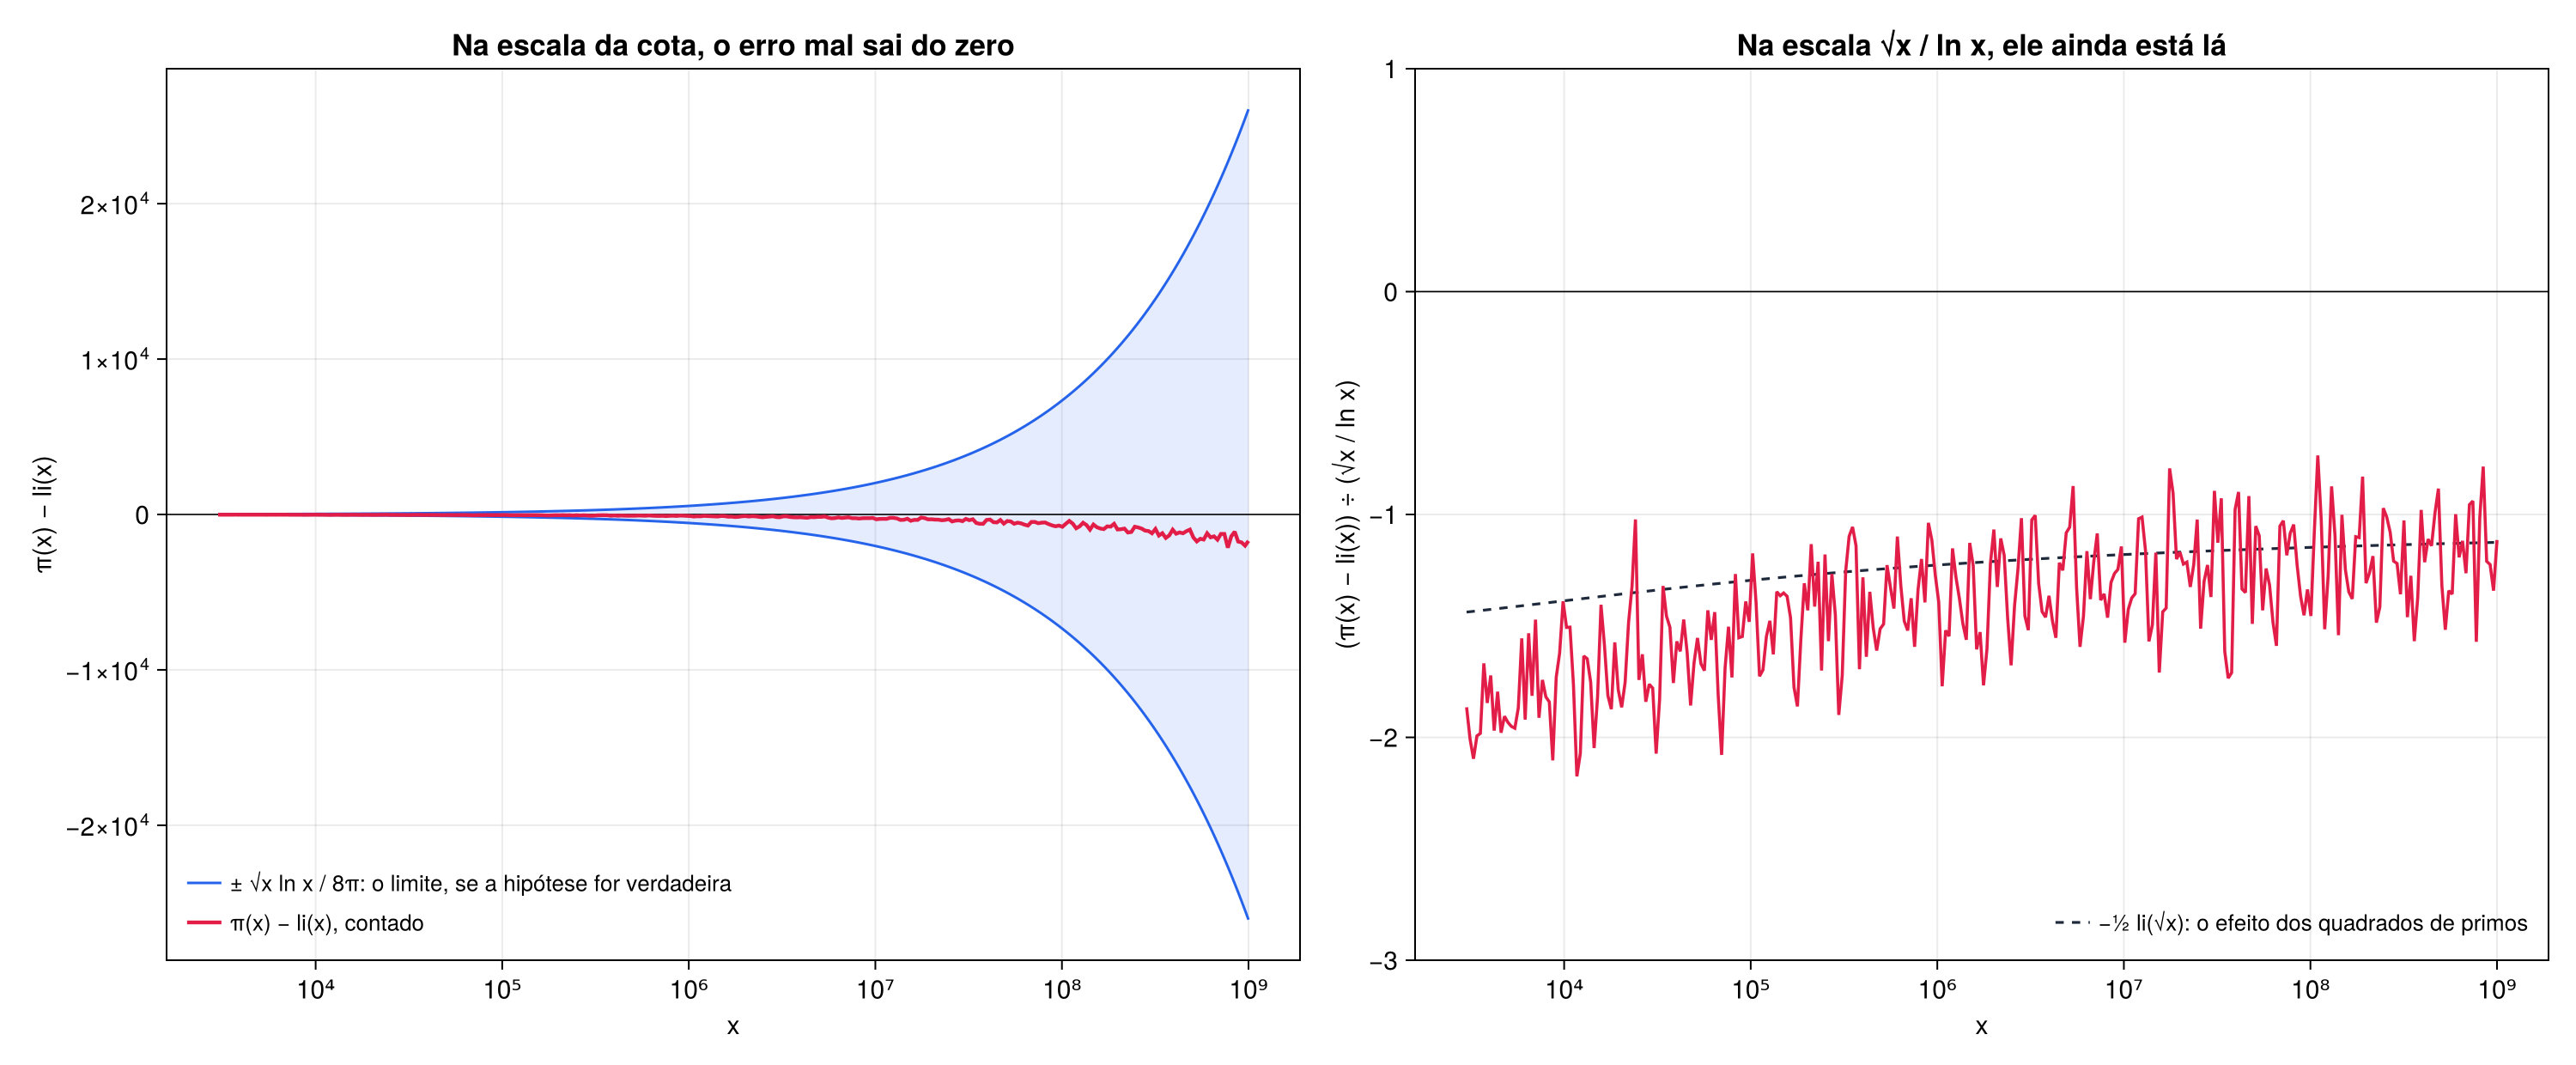
À esquerda, folga enorme: em um bilhão, o erro é 1.701 e a cota permite 26.075. O painel da direita mostra que o erro tem mesmo o tamanho de $\sqrt{x}/\ln x$ — nem some, nem explode —, e que ele fica teimosamente negativo, flutuando entre −2,2 e −0,7 e subindo devagar em direção a −1.
Esse −1 tem explicação, e ela me fez gostar ainda mais da fórmula explícita. $\operatorname{li}(x)$ é, na verdade, a aproximação natural para uma contagem que inclui as potências de primos com peso: os quadrados de primos entram com peso 1/2, os cubos com 1/3… Como $\pi(x)$ conta só os primos, ele fica abaixo de $\operatorname{li}(x)$ por cerca de $\tfrac12 \operatorname{li}(\sqrt{x})$, a linha tracejada. Para $x$ muito grande, isso é $\approx \sqrt{x}/\ln x$, o −1; mas a aproximação $\operatorname{li}(y) \approx y / \ln y$ converge devagar, e é por isso que a linha sai de −1,4 em $10^4$ e só chega a −1,13 em $10^9$. A curva vermelha fica um pouco abaixo da tracejada (os cubos de primos e os termos seguintes puxam mais um pouco), e as oscilações em volta são as ondas dos zeros.
Os dados mentem (às vezes por muito tempo)
Olhando a tabela e a Figura 3, qualquer pessoa razoável apostaria que $\pi(x) < \operatorname{li}(x)$ sempre. Gauss parece ter achado isso. Ela foi verificada para todo $x$ até $10^{19}$, e vale em todos os pontos em que $\pi(x)$ já foi calculado exatamente, que passam de $10^{25}$.
E ela é falsa. Em 1914, John Littlewood provou que $\pi(x) - \operatorname{li}(x)$ troca de sinal infinitas vezes. O viés que aparece na Figura 3 é real, mas de vez em quando as ondas dos zeros se alinham e vencem o viés. Ninguém encontrou a primeira troca de sinal: sabe-se que não há nenhuma antes de $10^{19}$ e que há uma antes de $1{,}4 \times 10^{316}$. O primeiro limite superior, de Stanley Skewes, em 1933 — e supondo a própria hipótese de Riemann —, era um número cuja quantidade de algarismos tinha, ela mesma, mais de $10^{34}$ algarismos.
Para um blog de estatística, essa é talvez a lição mais útil do post. Um bilhão de casos a favor, uma regularidade que dura até onde a vista alcança, e a afirmação é falsa. Os primos têm escalas em que coisas acontecem que são simplesmente grandes demais para amostrar.
É por isso que os matemáticos não se dão por satisfeitos com o fato de que a hipótese de Riemann foi verificada para os primeiros 12 trilhões de zeros, com rigor, por David Platt e Tim Trudgian em 2021 (todos os zeros até a altura $3 \times 10^{12}$). É evidência. Não é prova.
Um histograma que veio da física
A última coisa que eu fiz foi a que eu menos esperava que desse algo.
Se os primos se comportam “como se fossem aleatórios”, talvez os zeros também. Peguei os 20.000 zeros, corrigi o fato de que eles vão ficando mais juntos (usando a fórmula de densidade lá de cima, para que a distância média vire 1) e fiz o histograma das distâncias entre vizinhos. Fiz o mesmo com os primos entre $10^8$ e $1{,}2 \times 10^8$:
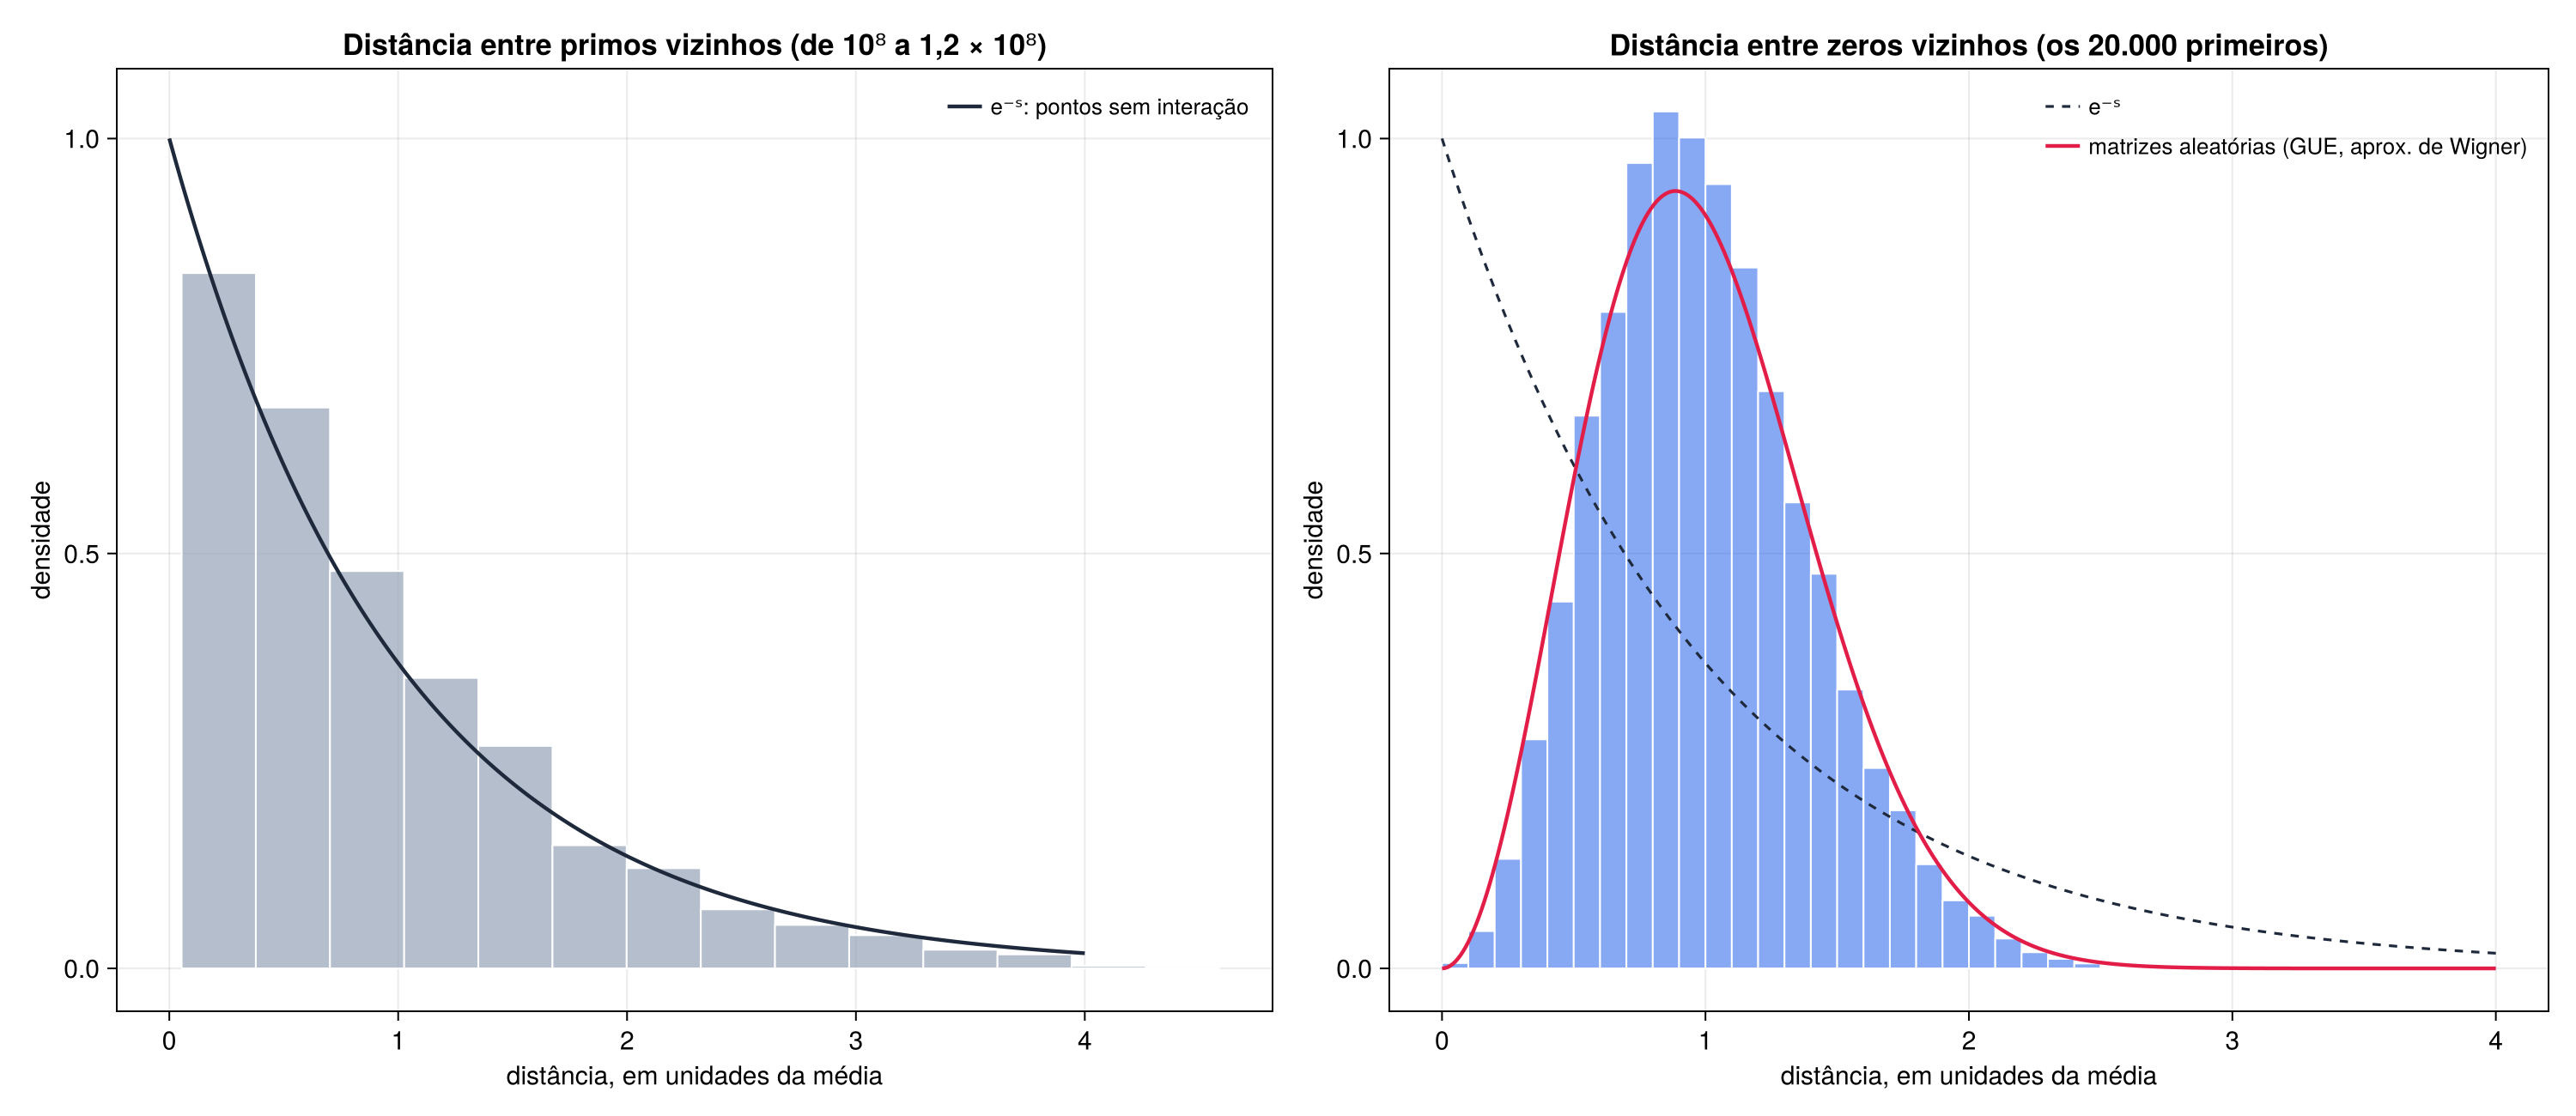
Os primos, à esquerda, se parecem com pontos jogados ao acaso: distâncias pequenas são as mais comuns, e as barras acompanham a exponencial.3 Mas o agrupamento de três em três esconde uma estrutura fina. Olhando distância por distância, 2 e 4 aparecem cada uma em 7,1% dos pares, e 6 em 12,6%, quase o dobro. O culpado é o 3: para $p$ e $p + 2$ serem primos, $p$ precisa deixar resto 2 na divisão por 3 (senão $p + 2$ é múltiplo de 3), e para $p + 4$, resto 1; já $p + 6$ deixa o mesmo resto que $p$, então nunca é barrado por isso. Por esse motivo, contando só as distâncias abaixo de um quarto da média (2 e 4), os primos ficam com 14% dos pares, contra 22% de pontos ao acaso.
Os zeros, à direita, são outra coisa. Eles se repelem: quase nunca ficam muito perto um do outro. Só 1,07% dos pares vizinhos estão a menos de um quarto da distância média. A curva vermelha, que é a aproximação de Wigner para o GUE, prevê 1,6%; a diferença diminui com a altura (nos primeiros 5.000 zeros, 0,94%; nos últimos 5.000, 1,22%), e é sabido que, em alturas baixas como essas, os zeros convergem devagar para a previsão.
A curva vermelha que se ajusta tão bem aos zeros não veio da teoria dos números. Ela descreve a distância entre os autovalores de matrizes hermitianas aleatórias grandes — o ensemble gaussiano unitário, ou GUE — e foi estudada nos anos 1950 e 1960 por físicos tentando entender os níveis de energia de núcleos atômicos pesados.
A conexão foi descoberta quase por acaso. Em 1972, Hugh Montgomery estava em Princeton com um resultado sobre a correlação entre pares de zeros (demonstrado supondo a própria hipótese de Riemann, e só para parte das escalas) e o mostrou, num chá do Instituto de Estudos Avançados, ao físico Freeman Dyson. Dyson reconheceu a fórmula na hora: era a mesma dos autovalores do GUE. Nos anos 1980, Andrew Odlyzko calculou milhões de zeros a alturas enormes e o ajuste ficou espetacular.
Ninguém sabe exatamente por quê. Uma ideia antiga, de Hilbert e Pólya, é que os zeros sejam os autovalores de algum operador ainda desconhecido; se esse operador for do tipo certo, os autovalores seriam reais, e isso é justamente a hipótese de Riemann. A estatística da Figura 4 é uma pista de que essa ideia talvez não seja só bonita. Mas é uma pista.
O que se sabe, então
Para separar o que está provado do que é só muito provável:
- Provado: há infinitos zeros na reta crítica (Hardy, 1914), e uma proporção positiva deles está lá — hoje, mais de 41% (as melhorias vêm do trabalho de Selberg, Levinson e Conrey).
- Provado: não há zeros sobre a reta $\operatorname{Re}(s) = 1$. Isso é essencialmente o teorema dos números primos.
- Verificado numericamente, com rigor: todos os zeros até a altura $3 \times 10^{12}$ estão na reta.
- Em aberto: todo o resto. Não se conhece nem uma faixa vertical $\operatorname{Re}(s) > 1 - \varepsilon$, de largura fixa, livre de zeros.
A hipótese foi o oitavo dos 23 problemas que David Hilbert propôs em 1900 para o século XX, e é um dos sete Problemas do Milênio do Instituto Clay, de 2000, com prêmio de um milhão de dólares. De tempos em tempos aparece uma demonstração anunciada — às vezes por matemáticos muito respeitados — e até hoje nenhuma resistiu à verificação.
A hipótese numa integral só
A hipótese também aparece disfarçada, em formulações que não lembram nem primos nem zeros. A minha preferida é de V. V. Volchkov, de 1995: ela é equivalente a uma única igualdade entre números.
\[\int_0^{\infty} \frac{1 - 12t^2}{(1 + 4t^2)^3} \int_{1/2}^{\infty} \ln\left|\zeta(\sigma + it)\right| \, d\sigma \, dt = \frac{\pi\,(3 - \gamma)}{32}\]Se essa conta der exatamente o número da direita, todos os zeros não triviais estão na reta crítica; se não der, algum está fora. Ela parece arbitrária, mas cada pedaço tem um papel.
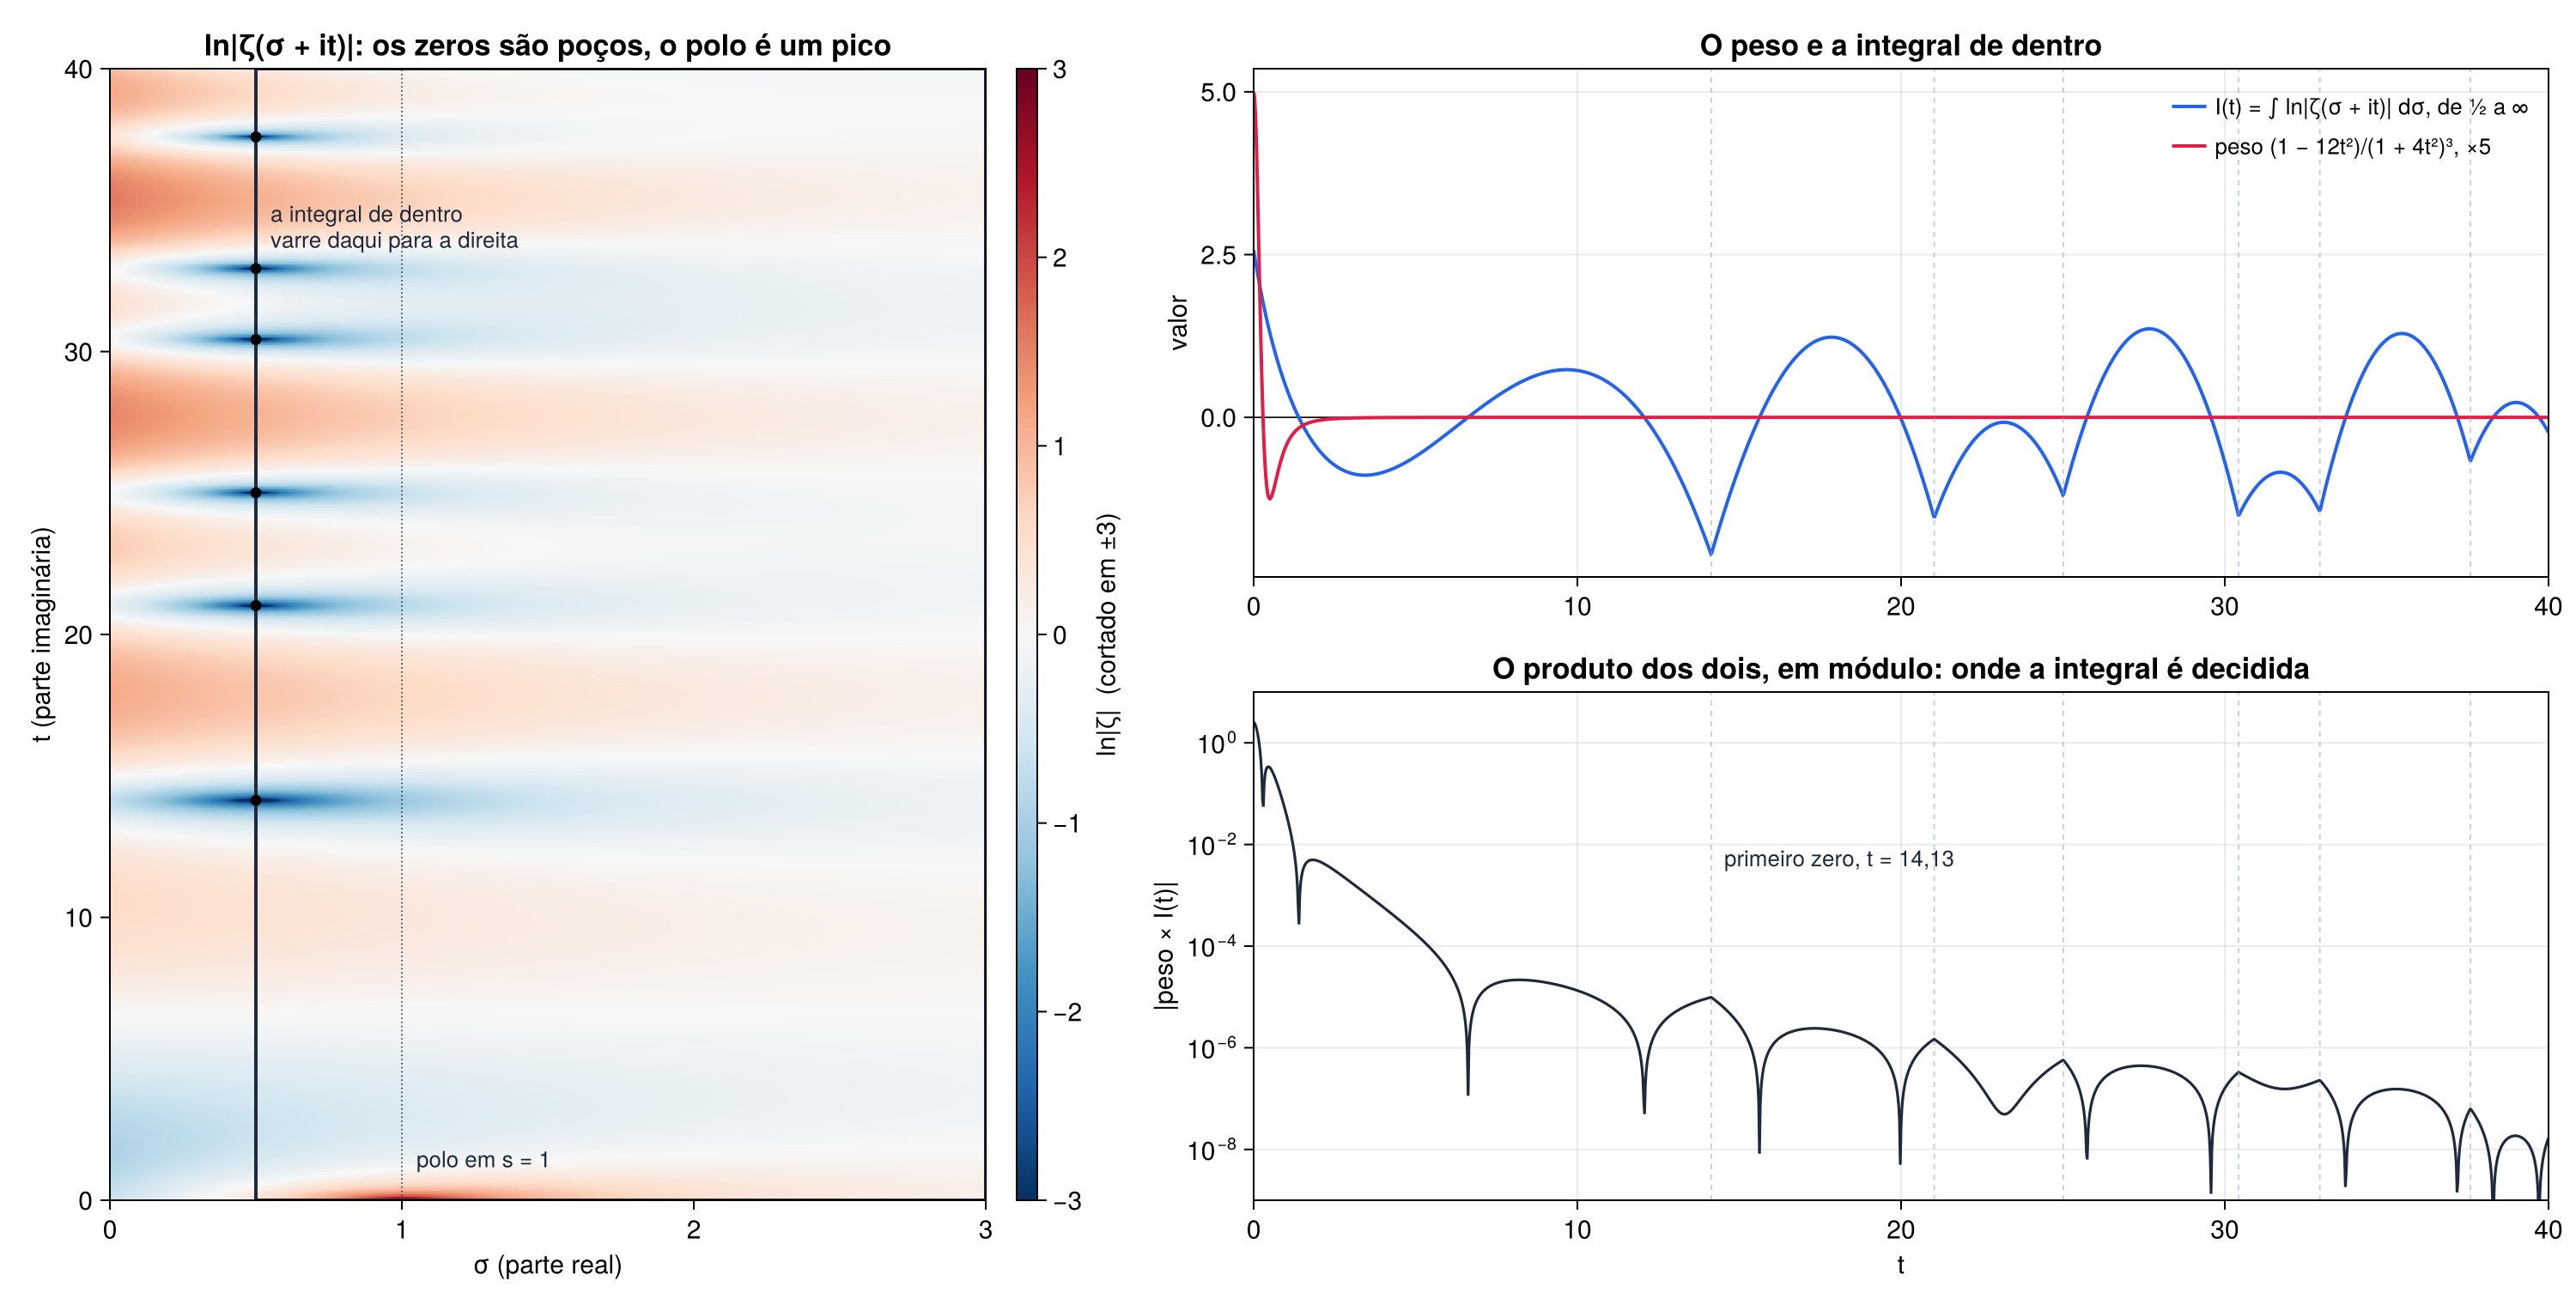
O logaritmo, $\ln\lvert \zeta(\sigma + it)\rvert$. Num zero, $\lvert \zeta\rvert = 0$ e o logaritmo vai a $-\infty$: cada zero vira um poço. No polo em $s = 1$, $\lvert \zeta\rvert$ vai ao infinito e o logaritmo vira um pico. Longe dos dois, $\ln\lvert \zeta\rvert$ é a parte real de $\ln \zeta$, uma função analítica, e por isso se comporta como um potencial elétrico no plano, em que os zeros e o polo fazem o papel de cargas. Essa é a razão de usar o logaritmo: integrais de um potencial “sentem” as cargas que estão dentro da região, e a análise complexa tem ferramentas exatas para contar essas cargas a partir das integrais.
A integral de dentro, de $\sigma = \tfrac12$ a $\infty$. Para cada altura $t$, ela anda na horizontal, da reta crítica para a direita. É justamente a metade da faixa crítica onde um zero fora da reta teria de aparecer: como os zeros vêm em pares simétricos, $\beta$ e $1 - \beta$, se houver algum fora da reta, um dos dois está à direita dela. Para a direita de $\sigma = 1$ não há zeros (o produto de Euler garante), e mais longe ainda $\zeta(s) \to 1$, o logaritmo vai a zero e a integral converge sem problema: em $\sigma = 45$, $\ln\lvert \zeta\rvert$ já é $3 \times 10^{-14}$. No gráfico do alto, a curva azul é o resultado, $I(t)$: ela tem um bico para baixo em cada zero, o rastro do poço que fica na borda esquerda.
O peso, $\dfrac{1 - 12t^2}{(1 + 4t^2)^3}$. Este é o pedaço que parece mais arbitrário e é o mais esperto. Ele é exatamente a parte real de $1/(1 + 2it)^3$, e, sobre a reta crítica, $1 + 2it = 2s$. Ou seja: o peso é a parte real de $1/(8s^3)$, uma função analítica cujo único polo está em $s = 0$, à esquerda de toda a região que a integral percorre. Por isso ele não cria singularidades novas do lado direito, e a integral dupla pode ser calculada de forma exata com as ferramentas de análise complexa: as únicas singularidades que contam são as da própria $\zeta$. O cubo garante que o peso caia como $t^{-4}$, rápido o bastante para tudo convergir. O peso vale 1 em $t = 0$, troca de sinal em $t = 1/\sqrt{12} \approx 0{,}29$ e, em $t = 3$, já é praticamente zero na escala do gráfico.
A integral de fora, de $t = 0$ a $\infty$. Só a metade de cima porque a de baixo é igual: $\lvert \zeta(\sigma - it)\rvert = \lvert \zeta(\sigma + it)\rvert$, e o peso é par. Com essa simetria, as duas integrais juntas cobrem o semiplano inteiro à direita da reta crítica.
O lado direito, $\pi(3 - \gamma)/32$. É quanto a integral vale se a única singularidade de $\zeta$ do lado direito for o polo em $s = 1$. O $\gamma$ aqui é a constante de Euler–Mascheroni, 0,5772…, e não a altura de um zero: ela aparece porque é o termo constante de $\zeta$ perto do polo, $\zeta(s) = \frac{1}{s - 1} + \gamma + \cdots$. O resto do número sai de fazer essa conta com o peso escolhido.
E a equivalência. Cada zero fora da reta, se existisse, acrescentaria uma parcela própria à conta, e o ponto do teorema de Volchkov é que essas parcelas não podem se anular. Se a igualdade vale, não há nenhum. Se não vale, há pelo menos um. A ideia de fundo é a da fórmula de Jensen, que conta os zeros de uma função dentro de um círculo integrando $\ln\lvert f\rvert$, e a do lema de Littlewood, que faz o mesmo num retângulo; aqui ela é aplicada a uma região infinita, com um peso escolhido para que a conta feche. Em 2012, Sekatskii, Beltraminelli e Merlini mostraram que a igualdade de Volchkov é um caso de uma família inteira de critérios desse tipo.
Calculei a integral cortando em $t = 300$: deu 0,237856295867, contra 0,237856295887 do lado direito, uma diferença na 11ª casa decimal.4 Parece uma confirmação, mas o painel de baixo da Figura 5 mostra de onde vem o valor. O produto do peso pela integral de dentro vale 2,6 em $t = 0$ e cai para menos de $10^{-5}$ depois do primeiro zero. Somado, tudo o que fica além de $t = 14{,}13$ contribui com 0,00000095, uns quatro milionésimos do total. A integral é decidida quase inteira perto de $t = 0$, onde não há zero nenhum. Um zero fora da reta numa altura de $10^{20}$ (abaixo de $3 \times 10^{12}$ já se sabe que não há nenhum) mexeria numa casa decimal que nenhum computador alcança. A igualdade é exata, e é inútil como teste: mais uma vez, a conta não substitui a prova.
O que eu levo deste post não é o prêmio. É a fórmula explícita: os primos, que parecem não ter regra, são uma tendência suave mais uma soma de ondas, e as frequências das ondas são os zeros de uma única função. A hipótese de Riemann diz que todas essas ondas crescem no mesmo ritmo, $\sqrt{x}$. Nenhuma grita mais que as outras.
Riemann achou isso “muito provável” depois de calcular uns poucos zeros à mão. Eu calculei 20.000 com um computador e acho a mesma coisa. Os dois podemos estar errados — os primos já enganaram gente melhor —, mas, se for o caso, vai ser a partir de uma altura que nenhum de nós vai ver.
Referências
- Riemann, B. (1859). Ueber die Anzahl der Primzahlen unter einer gegebenen Grösse. Monatsberichte der Königlich Preußischen Akademie der Wissenschaften zu Berlin, 671–680.
- Edwards, H. M. (1974). Riemann’s Zeta Function. Academic Press. Traz uma tradução comentada do artigo de Riemann.
- von Koch, H. (1901). Sur la distribution des nombres premiers. Acta Mathematica, 24, 159–182.
- Schoenfeld, L. (1976). Sharper Bounds for the Chebyshev Functions θ(x) and ψ(x). II. Mathematics of Computation, 30(134), 337–360.
- Littlewood, J. E. (1914). Sur la distribution des nombres premiers. Comptes Rendus de l’Académie des Sciences, 158, 1869–1872.
- Turing, A. M. (1953). Some calculations of the Riemann zeta-function. Proceedings of the London Mathematical Society, s3-3(1), 99–117.
- Bays, C.; Hudson, R. H. (2000). A new bound for the smallest $x$ with $\pi(x) > \operatorname{li}(x)$. Mathematics of Computation, 69(231), 1285–1296.
- Büthe, J. (2018). An analytic method for bounding $\psi(x)$. Mathematics of Computation, 87(312), 1991–2009.
- Volchkov, V. V. (1995). On an equality equivalent to the Riemann hypothesis. Ukrainian Mathematical Journal, 47(3), 491–493.
- Montgomery, H. L. (1973). The pair correlation of zeros of the zeta function. Proceedings of Symposia in Pure Mathematics, 24, 181–193.
- Odlyzko, A. M. (1987). On the distribution of spacings between zeros of the zeta function. Mathematics of Computation, 48(177), 273–308.
- Platt, D.; Trudgian, T. (2021). The Riemann hypothesis is true up to $3 \cdot 10^{12}$. Bulletin of the London Mathematical Society, 53(3), 792–797.
- Conrey, J. B. (2003). The Riemann Hypothesis. Notices of the American Mathematical Society, 50(3), 341–353. A melhor introdução curta que eu conheço.
-
No original: “Es ist sehr wahrscheinlich, dass alle Wurzeln reell sind. Hiervon wäre allerdings ein strenger Beweis zu wünschen; ich habe indess die Aufsuchung desselben nach einigen flüchtigen vergeblichen Versuchen vorläufig bei Seite gelassen”. Ele fala em raízes reais porque escreve a função numa variável deslocada e girada, em que a reta crítica vira o eixo real. É o mesmo enunciado. ↩
-
Trocar
0.5 + im*gpelo zero completo que ofpwrap_zeta_zerodevolve não tiraria a suposição do código, só a esconderia melhor: a biblioteca procura os zeros na reta crítica, então a parte real que ela devolve é 1/2 por construção. Quem garante que é 1/2 de verdade, para esses zeros, é a verificação numérica, não o meu código. ↩ -
Essa é a intuição do modelo de Harald Cramér, dos anos 1930: tratar cada inteiro $n$ como primo com probabilidade $1/\ln n$, de forma independente. O modelo erra em detalhes — por exemplo, dois primos ímpares nunca estão a uma distância ímpar, e distâncias múltiplas de 6 são mais comuns que as outras —, mas acerta a forma geral, que é a que aparece na figura. ↩
-
Integrei em Julia com o pacote QuadGK, avaliando $\zeta$ com o
fpwrap_zetado Arblib. A integral de dentro vai de $\sigma = 1/2$ a 45 (depois disso, $\ln\lvert \zeta\rvert$ é menor que $10^{-13}$), e a de fora foi quebrada nas alturas dos zeros, onde $\ln\lvert \zeta\rvert$ tem singularidades na borda $\sigma = 1/2$. Há outra singularidade no polo, em $s = 1$, e as duas são integráveis. Depois de $t = 300$ o peso já vale $2 \times 10^{-11}$, e uma cota grosseira para o que o corte deixa de fora é da ordem de $10^{-8}$; a diferença observada, $2 \times 10^{-11}$, mostra que na prática é bem menos. A conta levou 36 segundos. ↩
Comentários